1. llm-d가 아닌 것부터 본다
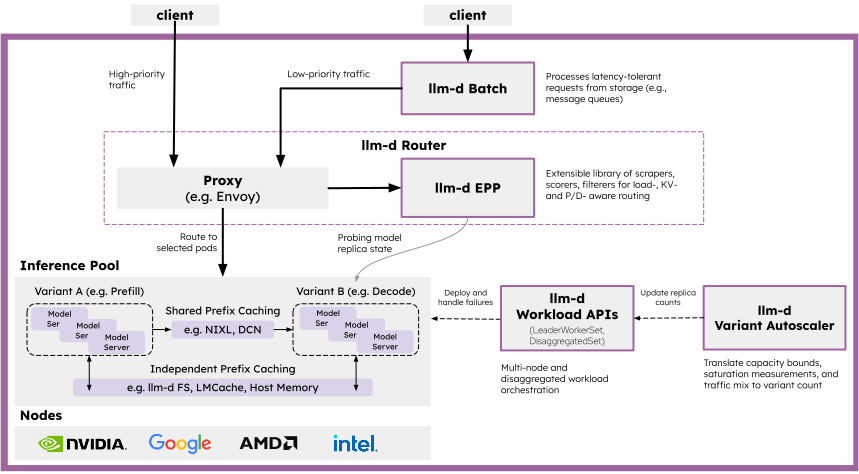
llm-d는 언어 모델도, vLLM·SGLang을 완전히 대체하는 엔진도, 소비자용 API도 아니다. 모델 서버와 Kubernetes 위에서 요청을 받고 엔드포인트를 고르며 KV 캐시 상태와 서빙 그룹을 조정하는 오픈소스 계층이다.
답변 품질로 폐쇄형 모델과 비교하면 안 된다. 일반 로드밸런서와 고정 GPU 풀을 쓰는 현재 설계와, 컨텍스트·부하·우선순위를 이해하는 제어 계층을 같은 부하에서 비교해야 한다.
2. 1.0이 Day 2 운영에 더한 것
안정적 v1 설정 API, 우선순위와 공정성을 고려한 흐름 제어, prefill/decode 그룹의 연동 롤아웃, 세션 캐시를 활용하는 라우팅이 핵심이다.
하지만 무중단은 자동 보증이 아니다. 고가용성 구성, 장애 시험, 버전 호환성, 관측성이 필요하다. ‘에이전트 인지’도 세션 운영을 뜻할 뿐 에이전트의 판단 품질을 검증하지 않는다.
3. 왜 prefill과 decode를 나누나?
긴 입력을 읽는 prefill은 계산 집약적이고 이후 토큰 생성은 메모리와 대역폭의 제약을 더 받는다. 서로 다른 풀을 두고 KV 상태를 전송하면 부하에 맞춰 각각 확장할 수 있다.
대신 데이터 이동과 네트워크 의존성, 양쪽 버전 조정이 생긴다. 작고 짧은 부하에는 단순한 구성이 더 나을 수 있다. 1.0은 분리를 운영 가능하게 만들지만 항상 정답으로 만들지는 않는다.
4. 성능 수치는 구매 약속이 아니라 시험 사례다
프로젝트는 캐시 인지 라우팅이 라운드로빈보다 출력 처리량을 세 배 높인 사례 등 여러 결과를 공개했다. 각 결과는 모델·가속기·동시성·컨텍스트·기준선에 묶여 있다. AI World Signal은 이를 재현하지 않았으므로 프로젝트와 파트너 주장으로 구분한다.
실제 입력·출력 길이, 접두어 재사용, 동시성, 우선순위, 첫 토큰 목표를 재생해야 한다. 평균뿐 아니라 장애와 업그레이드도 측정한다.
5. 판단 예시: 언제 파일럿할까?
GPU 네 장에서 한 모델을 안정적 트래픽으로 돌리고 짧은 세션만 있다면 복잡도가 먼저 늘 수 있다. 여러 테넌트, 긴 컨텍스트 에이전트 급증, 무중단 업그레이드, 이기종 하드웨어가 문제라면 제한된 시험 가치가 커진다.
일주일 기준선을 저장하고 대표 부하로 시험한다. 성공 기준은 설치 완료가 아니라 지연·비용 목표, 통제된 장애, 문서화된 롤백을 함께 만족하는 것이다.